TrainSphere 分布式训练平台
项目简介
组织深度学习训练任务、计算节点与执行流程,构建便于管理的分布式训练平台。
项目图示
正文为原文,尚未提供此语言的译文。
项目背景
TrainSphere 是一个面向深度学习训练的分布式平台。项目针对单机训练中计算资源有限、任务执行时间长和扩展困难的问题,将训练任务分配到多台服务器,由主控节点统一管理任务和资源,训练节点负责实际计算。平台把任务调度、状态同步、负载调整和故障恢复放在同一套管理流程中,方便集中查看训练进度,也便于在原有资源不足时增加计算节点。
系统设计与实现
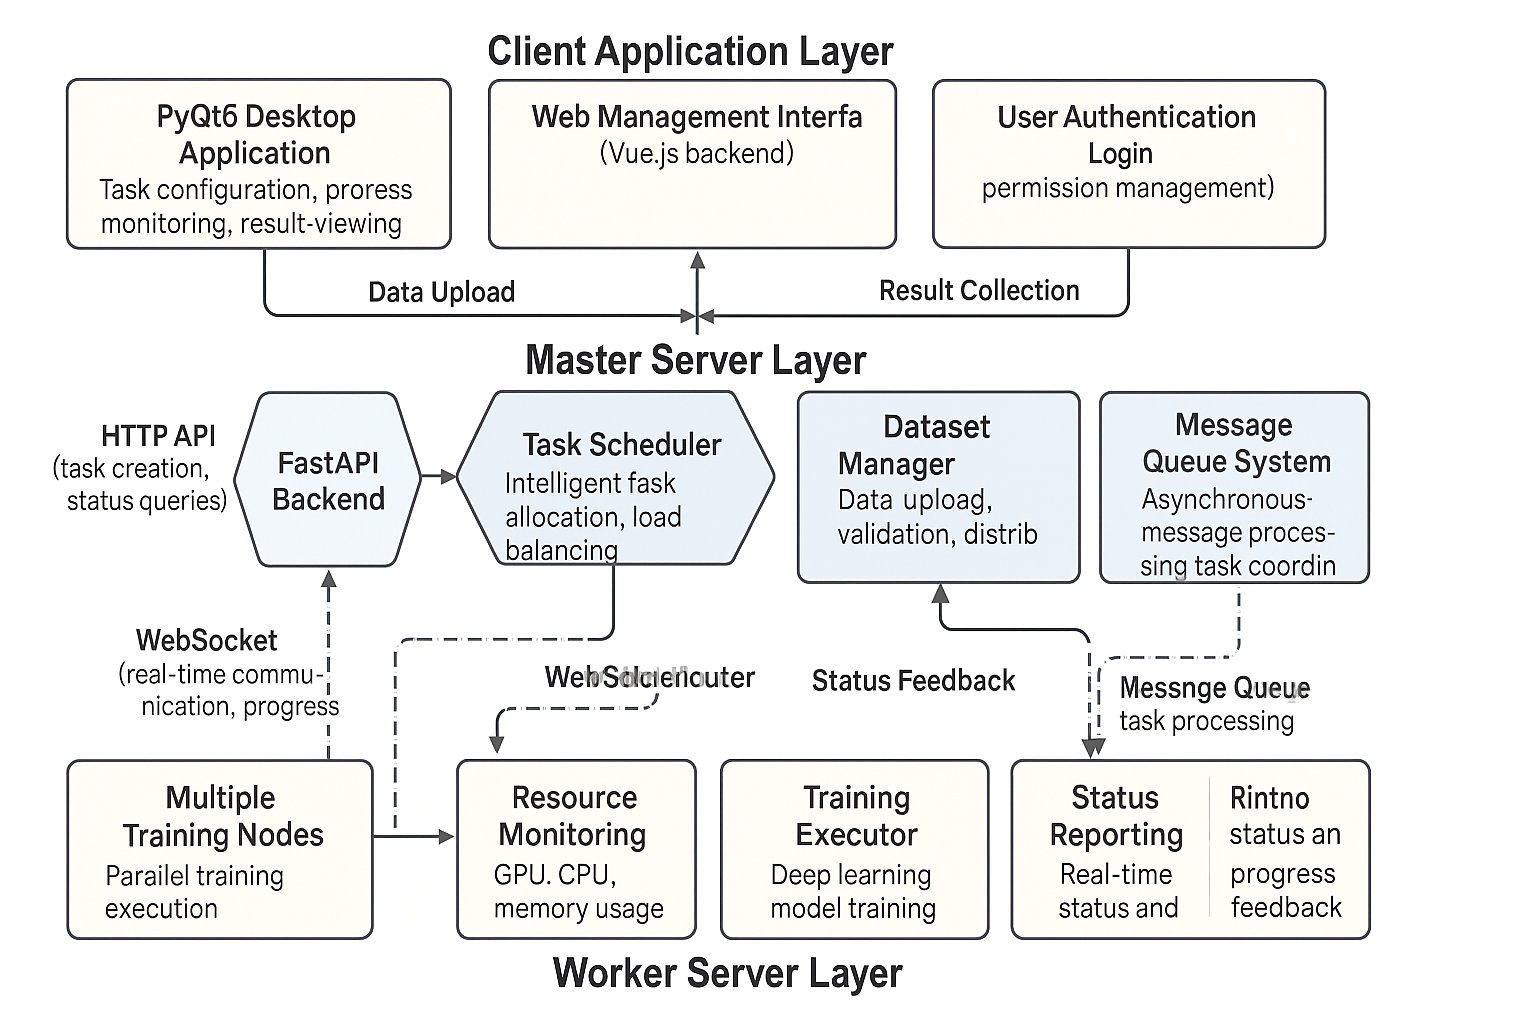
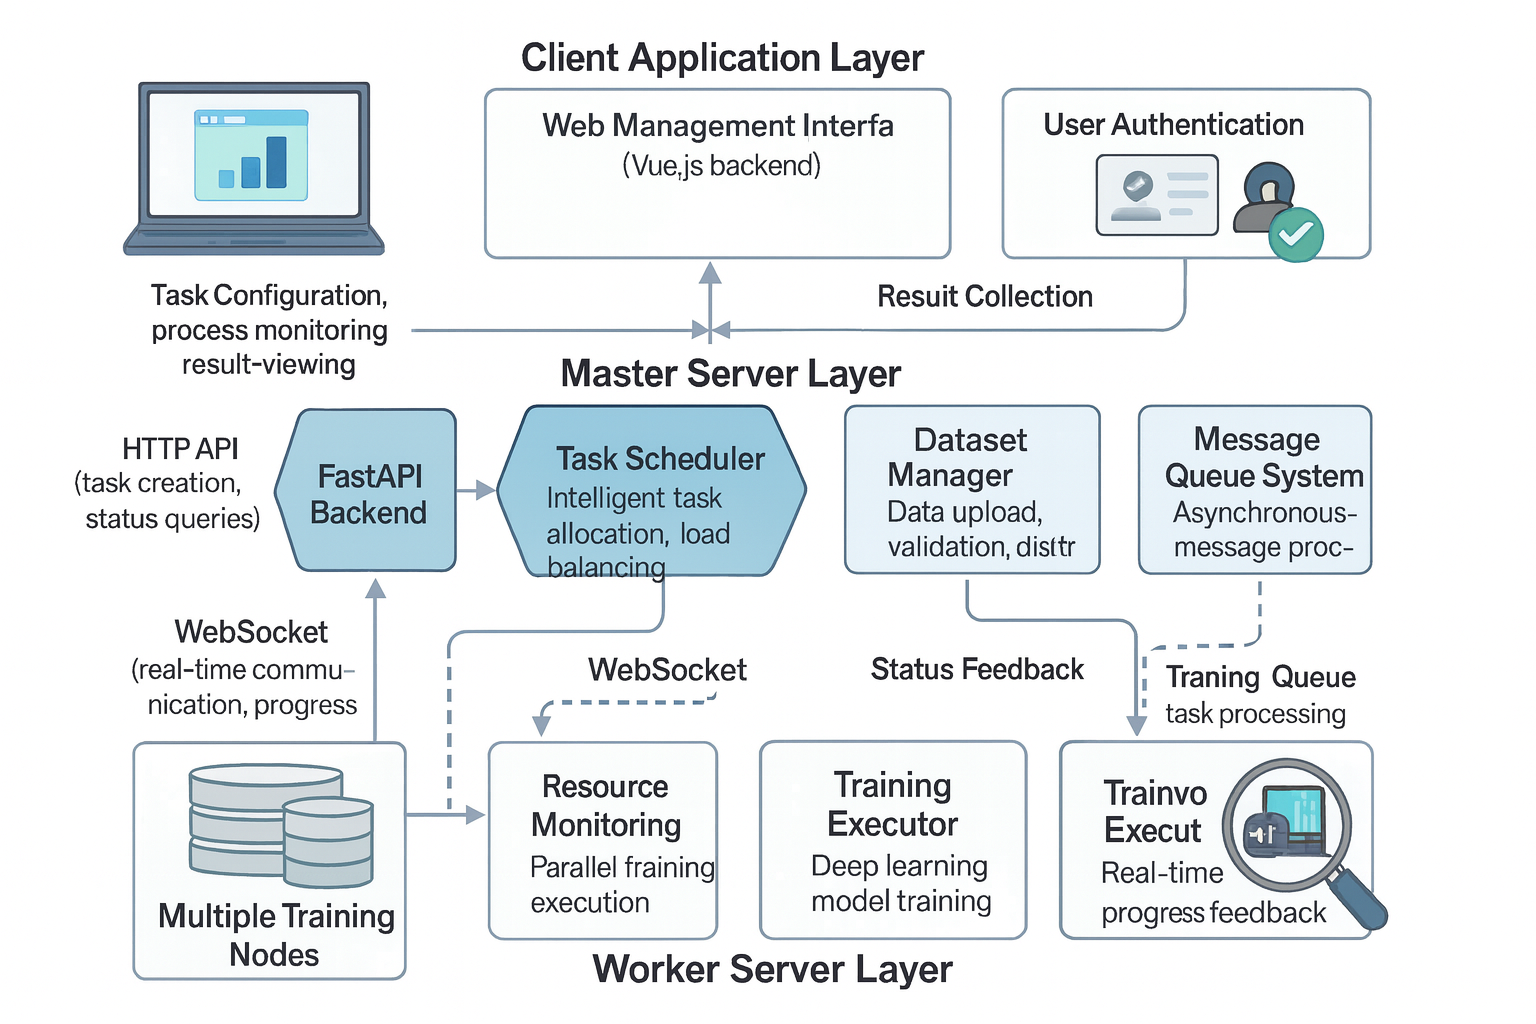
系统采用 Master–Slave 架构。主控节点负责接收和调度任务,根据各训练节点的计算能力、内存状态与网络状况分配资源,同时持续监控训练进度。训练节点执行模型训练、梯度计算和更新,管理本地资源并向主控节点上报状态。节点之间通过 WebSocket 进行实时双向通信,异步消息队列负责缓冲和处理消息,心跳检测用于识别节点是否在线。通信层还包括数据序列化、断线重连和消息重传,以应对训练过程中可能发生的连接中断。
任务分配支持优先级、资源预留和抢占式调度。训练开始后,平台持续观察节点的资源使用情况,调整分配策略,尽量减少部分节点繁忙而其他节点空闲的情况。发现节点故障或网络异常时,系统重新分配受影响的任务,并执行恢复流程。监控界面集中展示节点状态、训练进度和性能统计,通过告警提示异常,减少逐台检查服务器的操作。
项目记录中的性能指标包括:相比单机训练,训练效率提升 300%;任务调度延迟低于 10ms,节点间通信延迟低于 5ms,故障恢复时间低于 30 秒,系统可用性为 99.9%,支持 100 个以上训练节点并发运行。这些指标对应调度、通信、恢复和资源规模等不同环节,具体部署时仍需结合模型、节点配置和网络条件评估。
应用与开发过程
平台主要面向需要多机计算资源的训练任务,例如语言模型、计算机视觉模型和推荐系统。对于企业内部的 AI 开发,可以用它组织多个团队和项目的并行训练,集中管理已有服务器;对于科研实验,则可以在同一套平台中安排不同框架和算法的实验任务。系统也考虑了容器化部署和云平台扩展,以便根据训练需求增减计算资源。
项目开发记录从 2024 年 1 月的系统设计开始,包括架构设计、技术选型和核心算法设计;2 月进入主从节点、通信模块及任务调度的开发,3 月集成负载均衡、故障检测和监控界面,4 月进行性能测试、压力测试与系统优化。整个实现过程围绕节点协作展开,使任务提交、执行、监控和异常恢复能够形成连续的工作流程。